EvoX の現代的な計算基盤では、テンソル化された並列処理と統一 Runtime によって算力规模というボトルネックが大幅に解消されました。個体群、評価結果、アルゴリズムの状態をまとめて GPU、アクセラレータ、分散クラスタ上で実行でき、数万回に及ぶ候補評価を逐次処理する必要はもうありません。計算力が開放されたことで、進化の効果を制限する短板は別の場所へ移りました——候補解を生成する方法そのものが、依然として人手で事前に設定され、実行中は固定されたままである。
従来の最適化の限界:解を探すだけで、探索の改善には関与しない
従来の最適化アルゴリズムは、与えられた探索空間で解を探すことにかけては非常に優れています。変異戦略、パラメータ群、近傍構造が与えられれば、候補解の生成・評価・再選択を繰り返します。問題は、この候補生成の仕組みが外部で設計された定数であり、アルゴリズムは実行中を通じてそれを変えることがありません。言い換えれば、探索されるのは「解」だけで、「解を生み出す方法」は探索されていないのです。
- 探索戦略、パラメータ、候補生成の仕組みは人手で事前に設定され、実行中は固定されたままである。
- 候補を生み出す方法が固定されると、システムは既定のパターンを繰り返すしかなく、問題・環境・フィードバックに応じて適応的に拡張することが難しくなる。
- アルゴリズムは解を探せても、それ自身は探索プロセスの改善に関与していない。
EvoX の鍵となる動作:問題階層を一層上げる
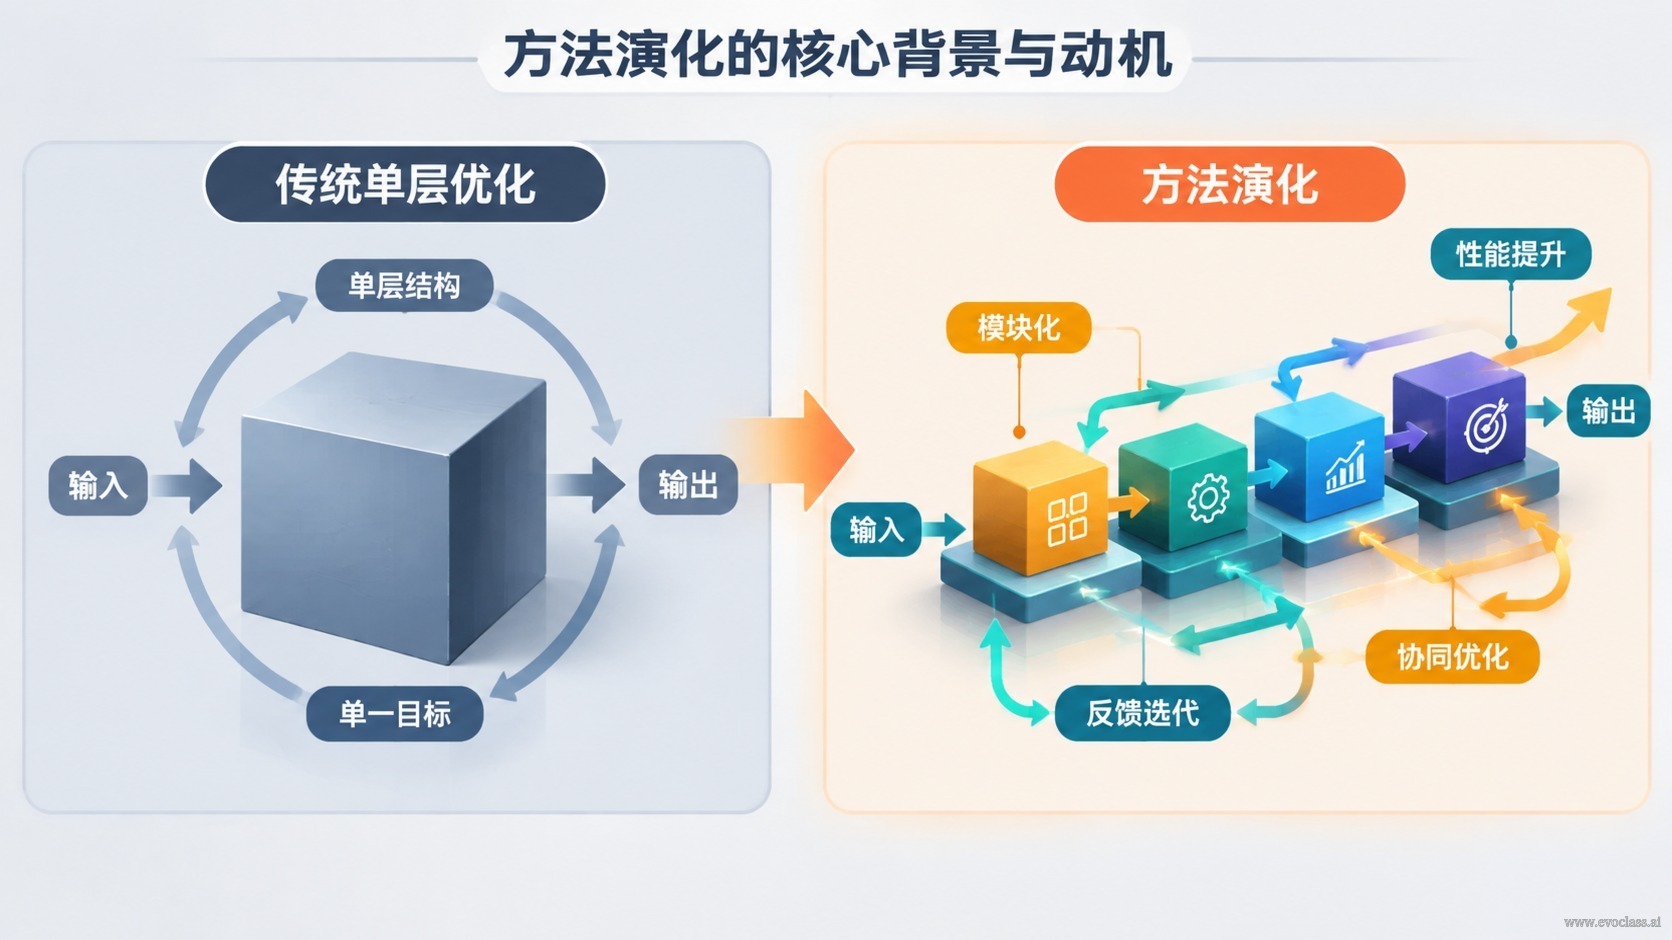
方法進化は「いかにして候補解を生み出すか」を、外部の設計上の選択から、探索可能・進化可能な対象へと変えます。EvoX の核心的な動作は、候補解を最適化するだけでなく、候補を生み出す方法をも最適化することです。たとえば差分進化における変異戦略、スケーリング因子 F、交叉率 CR といった設定は、進化ループに入り、フィードバックに応じて継続的に調整されます。
こうしてシステムは二つの階層で同時に探索します:「解」と「解を生み出す方法」。問題の形態が変わり、環境がドリフトし、あるいはフィードバック信号が変化したとき、方法の層もそれに応じて書き換えることができます。固定されたヒューリスティック戦略にあらゆる場面を無理に押し付けるのではありません。
なぜこの動機が以降の内容の土台となるのか
これが EvoX と一般的な最適化器との分水嶺を説明します。進化対象の境界がどのように外へ拡張され続けるか、アルゴリズム自身がどのように改善されるか、システムがどのようにカスケードと継続的進化へ向かうか——そのすべてがこの「階層上げ」の上に成り立っています。計算基盤が解決するのは「大規模に計算できるかどうか」であり、方法進化が解決するのは「大規模に計算しながら、探索方法も一緒に成長できるかどうか」です。
従来の単層最適化と方法進化の比較アーキテクチャ図図では二つの探索階層を対比しています。従来の最適化は固定された探索空間内で解を繰り返し生成・評価・選択するだけで、候補を生み出す戦略とパラメータは変わりません。一方、方法進化は変異戦略、スケーリング因子 F、交叉率 CR など解を生み出す方法も進化ループに組み込みます。こうしてシステムは「解」と「解を生み出す方法」の二つの階層で同時に探索し、問題やフィードバックに応じて継続的に調整できます。単にアルゴリズムを差し替えて再び固定するのではありません。